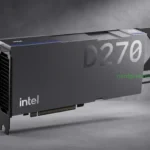
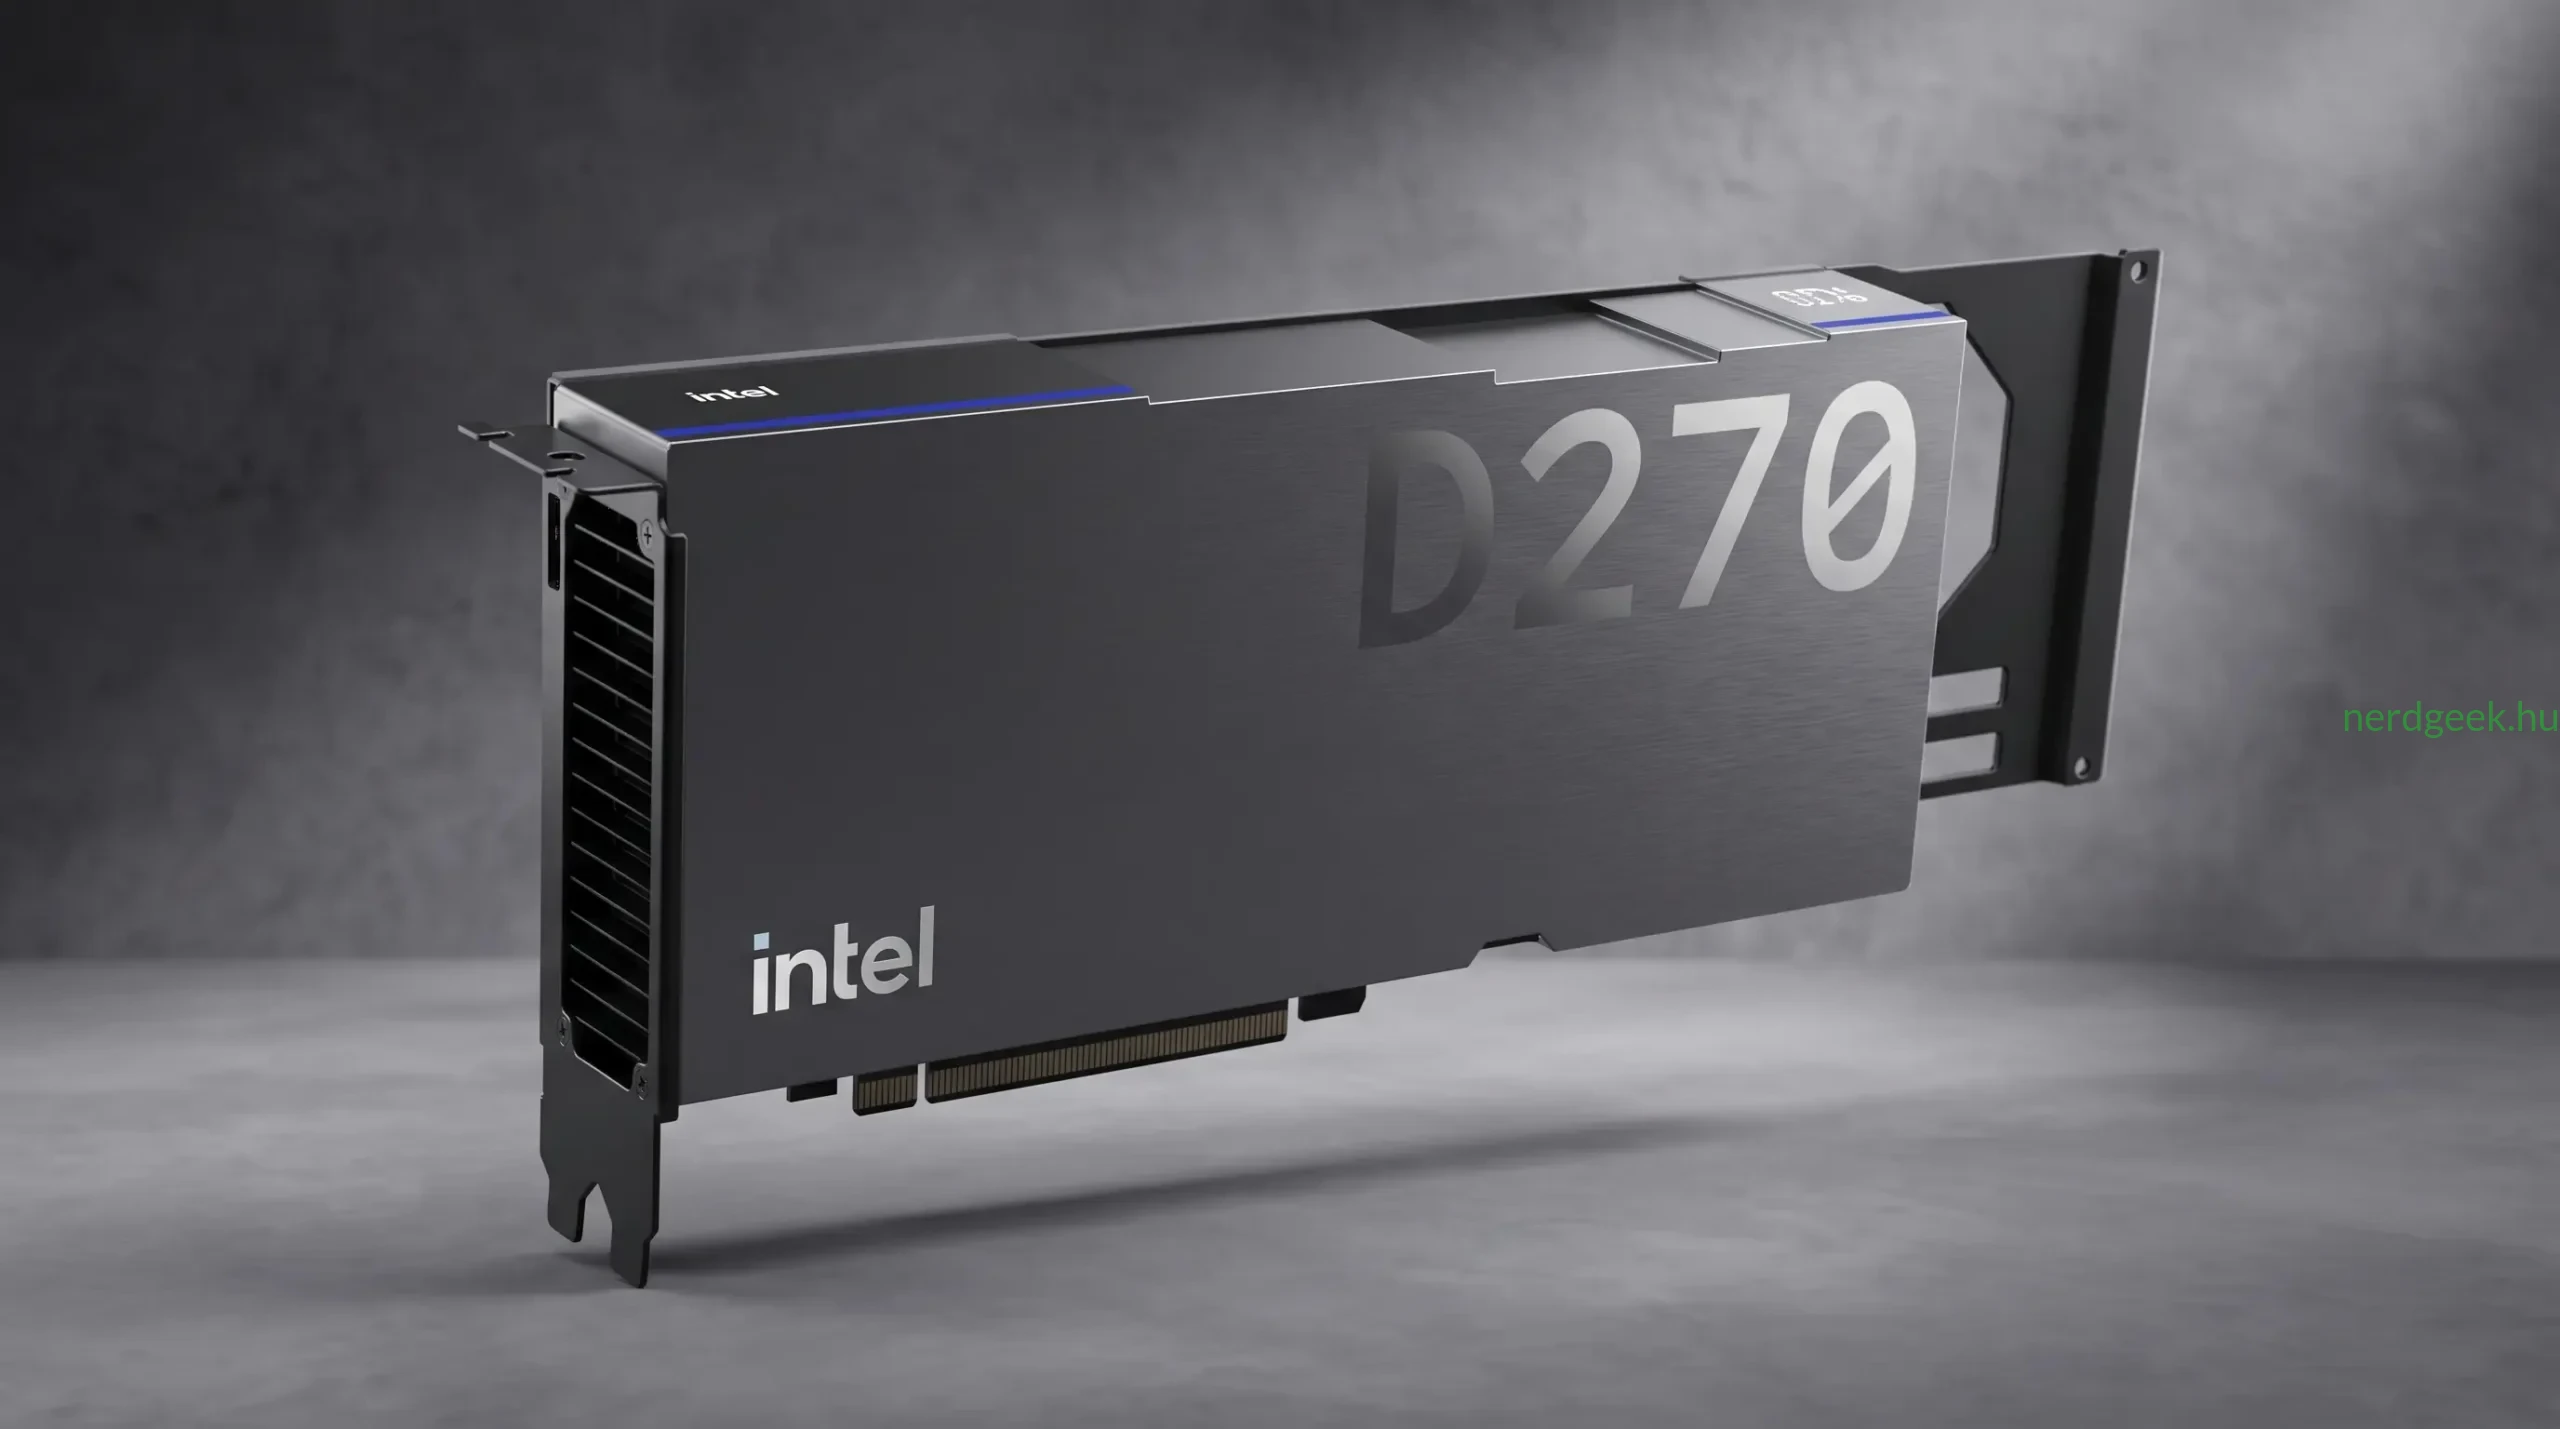
Az Open Compute Project rendezvényen hivatalos nevet kapott az Intel Crescent Island kódnéven ismert fejlesztése. A vállalat Intel GPU D-sorozat néven indítja útjára a mesterséges intelligencia következtetési (inference) feladataira szánt gyorsítócsaládot, amelynek első konkrét példánya a GPU D270 jelölést viseli. A kifejezetten adatközponti és szerveres környezetbe szánt eszköz szakít a hagyományos megközelítésekkel, és a méregdrága, ritka HBM memóriák helyett lényegesen költséghatékonyabb megoldásra támaszkodik.
Az Xe3P architektúrára épülő lapka elméleti csúcsteljesítménye eléri az 1,3 PFLOPS értéket FP8 számítások mellett, míg a memóriasávszélesség 1,5 TB/s. A kártyából az Intel saját márkás változata 160 GB LPDDR5X memóriát kap, azonban a partnergyártók (ODM-ek) akár 480 GB-ig is bővíthetik a kapacitást. Ez a hatalmas memóriakapacitás kulcsfontosságú a több százmilliárd paraméteres nyelvi modellek és a nagy kontextusablakkal dolgozó AI-szolgáltatások futtatásához.
Léghűtéses szerverekbe szánt felépítés
Az Intel GPU D-sorozat tervezésekor az egyik legfőbb szempont az egyszerű integrálhatóság volt. Míg a piacon elérhető legfejlettebb AI-gyorsítók jelentős része folyadékhűtést és több kilowattos tápellátást igényel, az új Intel kártya szabványos, 350 wattos TDP kerettel és léghűtéses PCIe 5.0 x16 formátumban érkezik. Ez lehetővé teszi, hogy a meglévő, hagyományos léghűtéses adatközponti infrastruktúrákba is különösebb átalakítás nélkül beépíthető legyen.
A szilícium felépítését tekintve a mérnökök teljesen eltávolították a klasszikus 3D grafikai és sugárkövetési (ray tracing) blokkokat. A felszabadult területet teljes egészében a számítási teljesítmény növelésére fordították: a lapka 32 darab Xe3P magot, 256 XMX mátrixmotort és 32 MB egyesített L2 gyorsítótárat tartalmaz. Az eszköz nem játékra vagy videórenderelésre való, hanem kizárólag nagyméretű nyelvi modellek, robotikai rendszerek és valós idejű AI-szolgáltatások kiszolgálására.
Rugalmas skálázhatóság az adatközpontokban
A nagy kapacitású LPDDR5X memória alkalmazása elsősorban a memóriakorlátos munkafolyamatoknál jelent előnyt. Az Intel adatai szerint egyetlen GPU D-sorozatú kártya képes akár 300 milliárd paraméteres AI-modellek futtatására, míg egy nyolc kártyából álló szerverkonfiguráció már az egymillió-milliárd (1 trillió) paramétert meghaladó rendszerek kezelésére is alkalmas. Az eszközt úgy tervezték, hogy alacsony késleltetés mellett, hatékony energiafelhasználással szolgálja ki a párhuzamosan futó lekérdezéseket.
A kártyák mintapéldányainak tesztelése már megkezdődött a partnereknél, a hálózati és szervergyártóknál, valamint az adatközponti szolgáltatóknál. A pontos árazásról és a széles körű piaci elérhetőségről a gyártó egyelőre nem közölt részleteket, azonban az LPDDR5X memória használata és a léghűtéses kiépítés lényegesen kedvezőbb bekerülési és üzemeltetési költségeket vetít előre.