
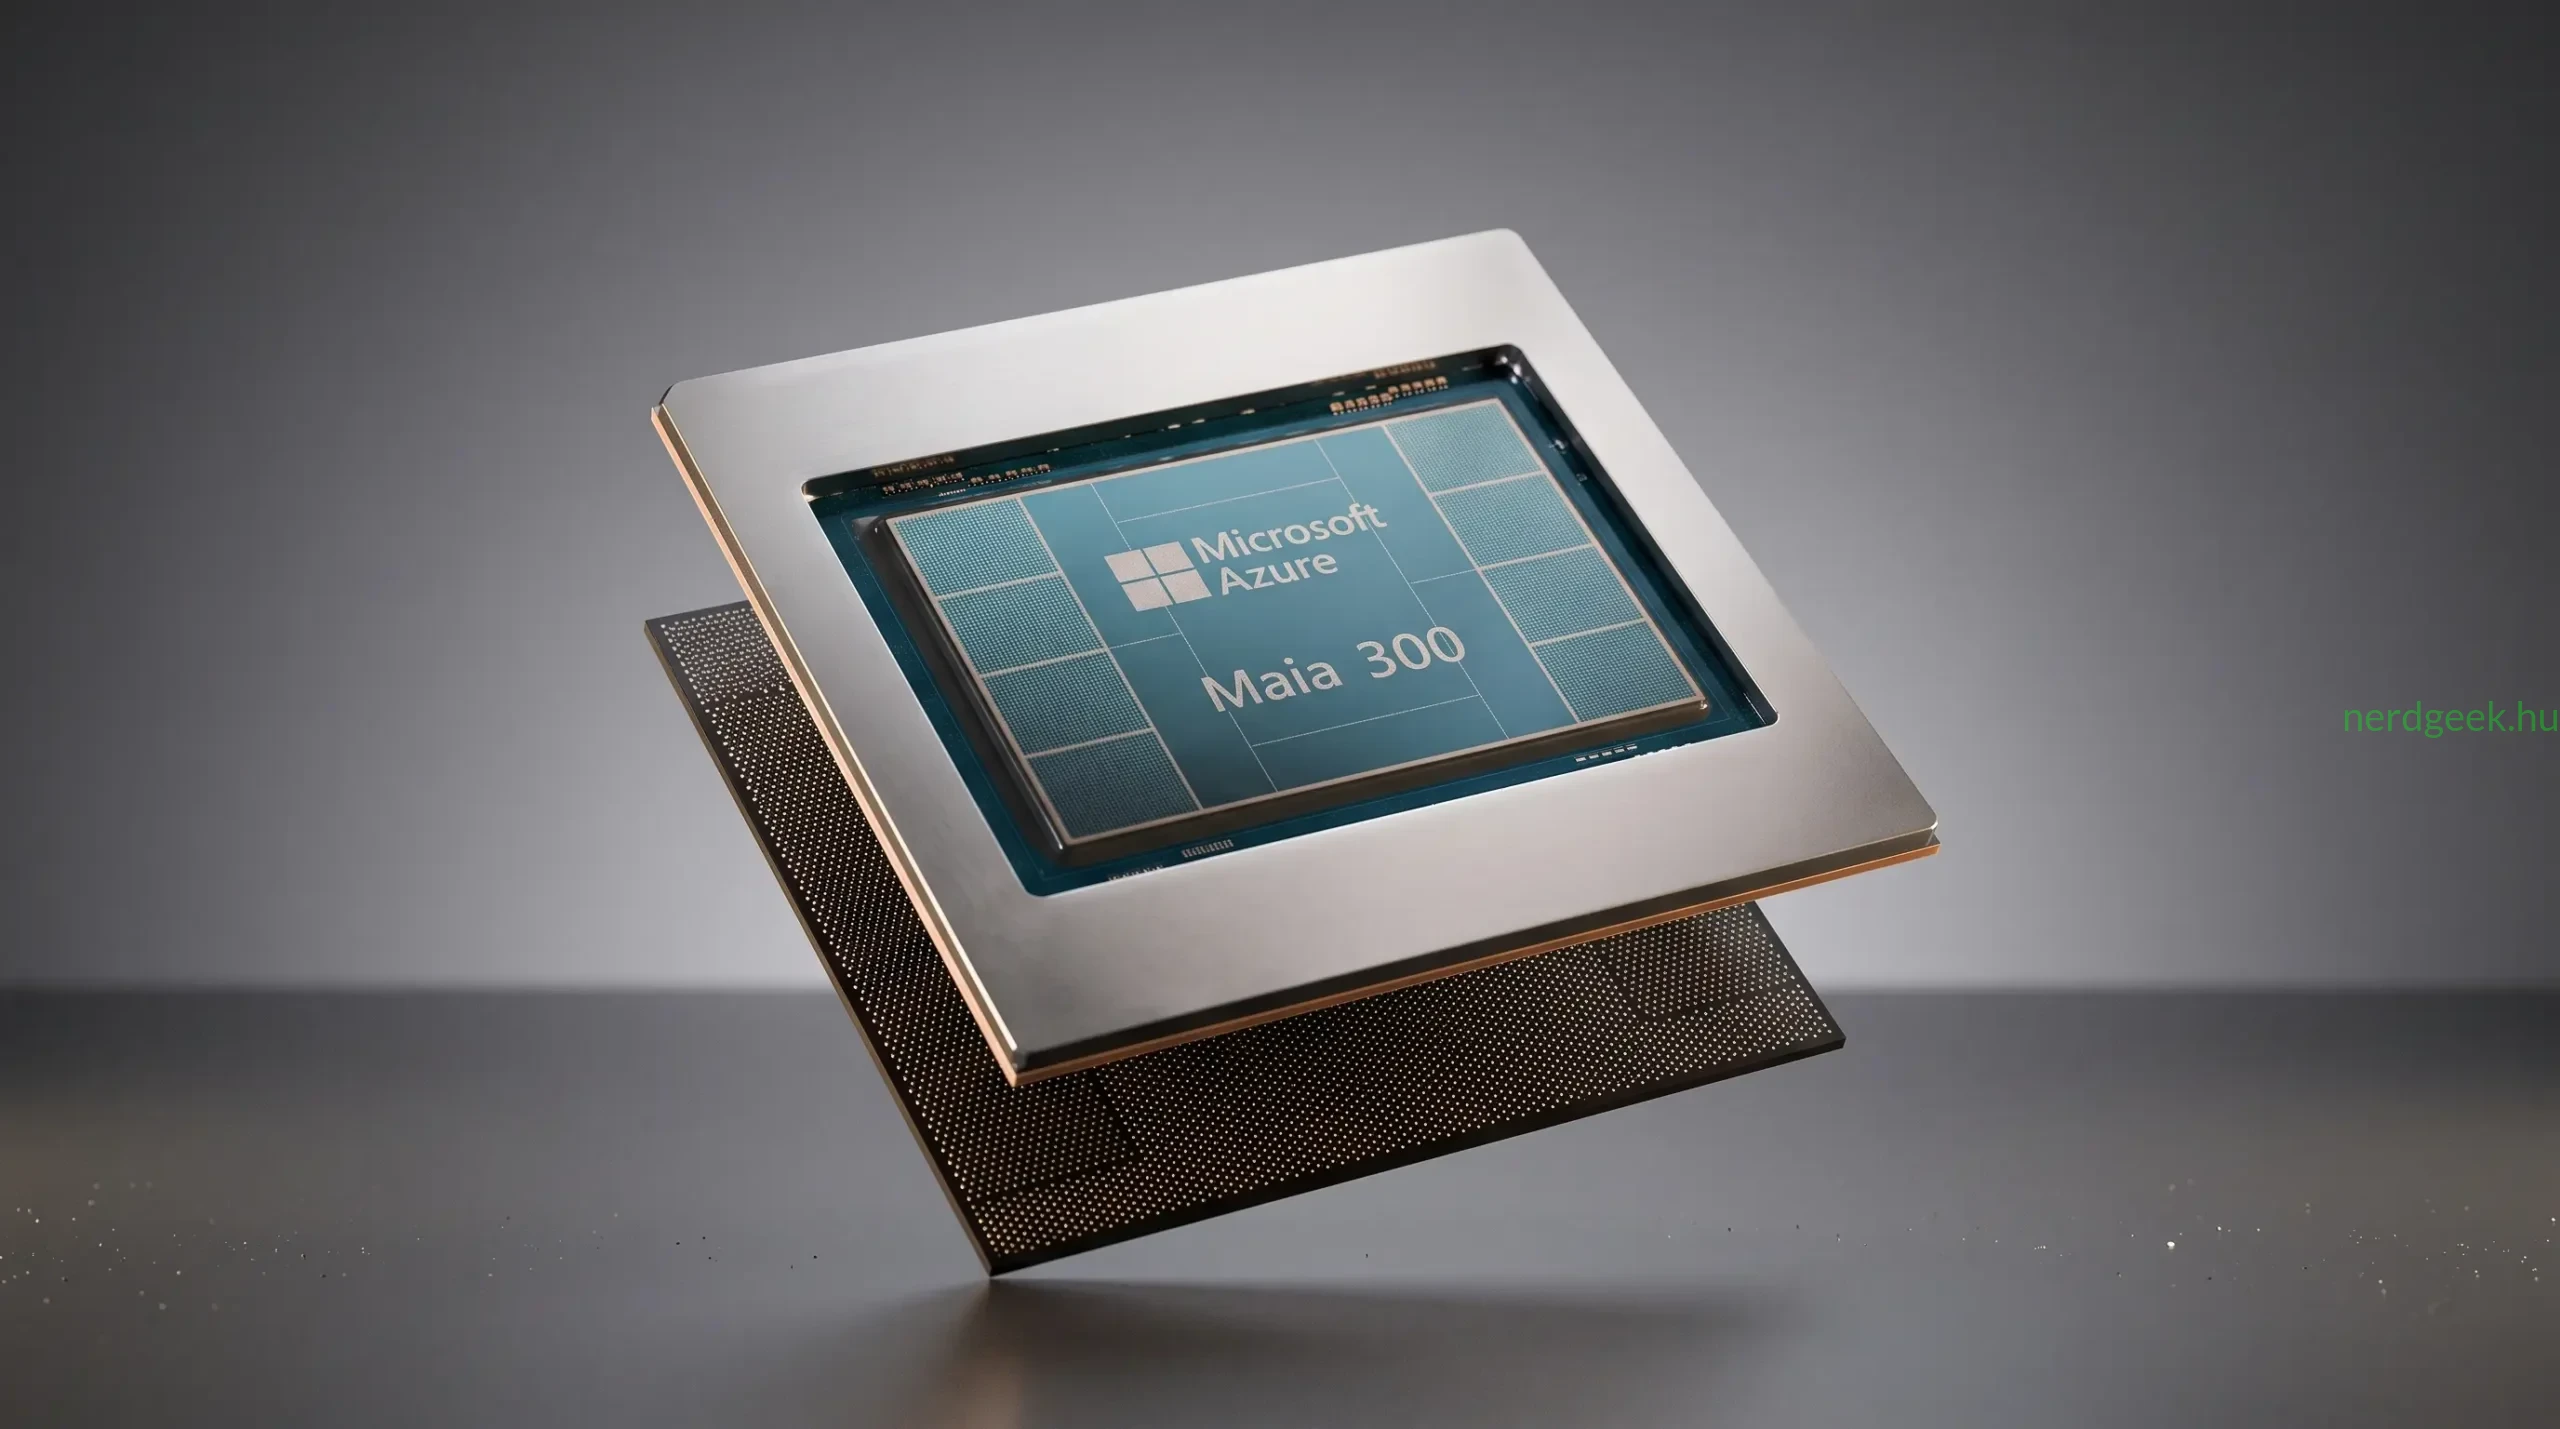
Saját fejlesztésű AI-gyorsítóval hirdet harcot a felhős számítási kapacitások piacán a redmondi szoftveróriás. A Microsoft Azure Maia 300 néven érkező processzor a vállalat eddigi legösszetettebb saját lapkája, amelyet kifejezetten a felhőalapú mesterséges intelligencia modellek futtatására terveztek. Az új architektúra célja, hogy jelentősen csökkentse a külső hardvergyártóktól való függőséget a nagyüzemi adatfeldolgozás során.
Fejlett chiplet-architektúra 2 nanométeren
A lapka szerkezete a TSMC legmodernebb N2P, azaz 2 nanométeres gyártástechnológiájára épülő fő számítási egységre támaszkodik. Ezt két különálló I/O chiplet egészíti ki, amelyek a gyors adatmozgatásért felelnek, így a lapka hatékonyabban osztja meg az erőforrásokat a feladatok között. A moduláris felépítés lehetővé teszi, hogy a legdrágább gyártási eljárást csak a leginkább teljesítménykritikus felületeken alkalmazzák, optimalizálva a költségeket.
A számítási kapacitás terén a rendszer FP4 pontosság mellett 13,8 peta-OPS, míg FP8 precizitásnál 6,9 peta-OPS teljesítményre képes. Az egyes processzorok maximális hőtervezési kerete (TDP) eléri a 950 wattot.
Kiugró memóriasávszélesség a összetett AI-modellhez
A nagy nyelvi modellek és az összetett ágensalapú rendszerek futtatásának egyik legnagyobb szűk keresztmetszete a memória-sávszélesség. A Microsoft Azure Maia 300 ezt a kihívást nyolc darab HBM4 memóriastackkel hidalja át, amelyek együttesen 288 GB kapacitást nyújtanak. A memóriabuszon átáramló adatsebesség eléri a másodpercenkénti 18 terabájtot, ami lényeges előrelépés az előző generációs megoldásokhoz képest.
A rendszer az adatközeliség megőrzésére törekszik, így a feldolgozás során minimálisra csökken a felesleges adatmozgatás. Ez különösen fontos az olyan többlépcsős feladatoknál, mint a kódfordítás vagy a hosszú kontextusú szövegek elemzése.
Rendszerszintű hatékonyság a GPU-kkal szemben
A vállalat nem csupán önálló chippént, hanem komplett adatközponti infrastruktúraként kezeli az eszközt. Egyetlen szerverállványban (rack) akár 96 darab gyorsító is helyet kaphat, ami 167 kilowattos energiaigényt jelent. A mérések alapján az egység wattarányosan 40 százalékkal több hasznos jelet képes feldolgozni a hagyományos GPU-alapú kiépítéseknél.
A tervezett többlépcsős skálázódás révén a szerverparkok akár 12 000 összekapcsolt lapkából álló klasztereket is működtethetnek. Ez a kapacitás szolgál majd alapul a Microsoft Copilot, a GitHub Copilot és a partnerek által használt felhőszolgáltatások mögött. A chipek éles bevetése a globális adatközpontokban a tervek szerint 2027-ben indul el.